[点晴永久免费OA]合同改了三版,你到底改了哪句?数海丹心做了个文本对比工具:逐行逐字比差异,增绿删红改黄,报告一键发人
当前位置:点晴教程→点晴OA办公管理信息系统
→『 经验分享&问题答疑 』
本文看点 01 01 同事说「合同我又改了一版」,你把两个 Word 并排放了两屏 02 02 起因是群里一连串的「怎么比」 03 03 这工具到底长什么样 01 01 同事说「合同我又改了一版」,你把两个 Word 并排放了两屏 周一早上,同事把文件甩过来:「合同我又改了一版,你帮我看看哪里改了。」 你打开两个 Word,把它们并排放好,左边一屏、右边一屏。 第一屏还行,你还能认真看。看到第二屏的时候,你发现两边的滚动位置对不上了——左边第 47 行,对应右边是第几行?你开始数。 数到第三屏,你已经放弃逐行比对了,改成「先用眼睛扫一遍,看着眼熟就跳过」。 然后你在群里回一句:「好像就改了几个数字,问题不大。」 「好像」和「问题不大」这两个词,就是这样来的。 比这更要命的是另外三个场面。 第一个是制度文件更新。 一份《考勤管理制度》改了 8 版,领导问「跟去年那版比,加删了哪些内容」。你手上只有最新版,去年那版在某个文件夹里,文件名还叫「制度(最终)(2).docx」。 第二个是论文查重的前置工作。 学生的论文和网上那篇「参考文章」重复在哪几段?在线查重平台上传一次要钱,而且论文还没定稿,传上去心里不踏实。 第三个是两份名单对账。 财务给的员工名单和人事给的那份,谁多了、谁少了、谁部门改了?两份 Excel 各两百行,你没法一眼看出来。 这三件事,我们做成了一个工具。 02 02 起因是群里一连串的「怎么比」 需求是从群里攒出来的,问的都差不多。下面这几个问题,就是把那些问法归拢之后剩下的——先把它们答了,因为答案直接决定了这个工具长什么样。 第一个问题:不是「看」不出来,是没有对的方法。 人眼比对两屏文本,本质上是在做一件人脑极不擅长的事——找细微差异。你的眼睛会自动跳过「看起来差不多」的地方,这在一百行里可能漏掉三五处,在合同里这三五处就是责任。 第二个问题:市面上的选择都不合适。 系统自带的没有;Beyond Compare 好用但要收费,公司不给报销;在线的倒是有,但你把合同传上去的那一刻,它就不在你手上了。合同、工资表、名单——这些东西不该上传到任何地方。 第三个问题:名单也能比。 而且比文本更好办——名单本质就是文本。 所以这个工具就三件事:比文本 / 认格式 / 出报告。 03 03 这工具到底长什么样 ✅ 三种对比粒度,按你需要换 01 整行:通用。合同、制度、日志、代码,一行一行对 02 逐字符:行内再高亮「到底改了哪几个字」 03 按段落句子:段落被人重新拆过、合并过的稿子,用这个 「按段落句子」不是花架子。 如果有人把一段话拆成两行、或者把两段合成一段(Word 里手一抖就会这样),整行对比会报出一大堆莫名其妙的差异。换成按句子,差异立刻干净很多。 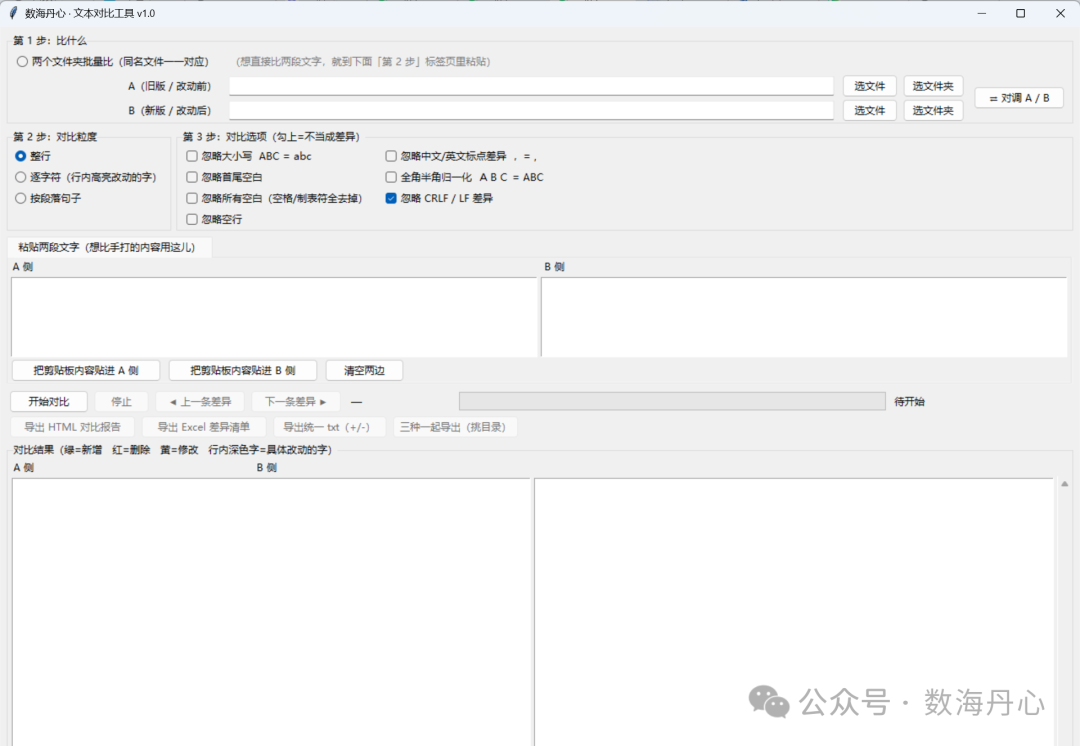 ✅ 七个对比开关,全部都带正反 忽略大小写 / 忽略首尾空白 / 忽略所有空白 / 忽略空行 / 忽略中文标点 vs 英文标点 / 全角半角归一化 / 忽略 CRLF vs LF。 默认只勾了 CRLF/LF 这一项,其余全关。为什么默认这么保守?因为对比工具不该偷偷改你的数据——你没说能忽略的东西,它就该报出来。 这里有个坑值得单说:全角半角归一化不能用 NFKC。 很多人的第一反应是用 unicodedata.normalize("NFKC") 做归一化。千万别。 NFKC 会把 ① 变成 1、㈠ 变成 (一)、Ⅻ 变成 XII。合同里的「第一条」「①附件」一旦被这么改写,对比就变味了——原文明明写的是「①」,工具报给你的是「1」,这已经不是对比,是篡改。 这个工具只做一件事:全角 ASCII 区(A-Z 0-9 和全角标点)加全角空格 → 半角。圈号、罗马数字、带圈汉字,一律不动。自检里有两条断言专门盯着这件事。 ✅ 文件类型:不是只能比 txt
编码全自动识别:UTF-8 / UTF-8-BOM / GBK / UTF-16 都能认。同一份内容存成这四种编码,工具比出来0 处差异(自检里断言了)。 docx 的抽取顺序是个容易忽略的细节。 老写法是先抽完所有段落、再抽所有表格——结果一份「文字 → 表格 → 文字」的制度文件,抽出来变成「文字、文字、表格」堆在一起,顺序跟人看到的完全不一样,对比结果会误导你去核对错误的位置。这个工具按文档里的真实顺序抽。 ✅ ★ PDF 扫描件没文字层,会明确告诉你 这条要单独说,因为它是最危险的静默失败。 扫描件(整页就是一张图)没有文字层。如果工具这时候静默返回一个空字符串,你会看到「两份 PDF 一模一样」——这比报错危险得多,因为你会拿着这个结论去做判断。 所以这个工具遇到没有文字层的 PDF,会直接给你一句人话: 这份 PDF 没有文字层(1 页全都没抽出文字),建议先 OCR —— 它是扫描件/图片转的 PDF,不是文本型 PDF 不许静默返回空,这条在自检里是一条硬断言:它会造一份纯图片 PDF,断言工具必须抛错,而且错误里必须出现「没有文字层」和「OCR」两个词。 ✅ 界面双栏并排,行号对齐,差异导航 左边 A 侧、右边 B 侧,行号对齐,增行绿底、删行红底、改行黄底,行内深色字就是具体改动的字(删掉的字带删除线)。 配上「上一条差异 / 下一条差异」,中间显示 3/12 处差异。连续差异算一处——连着改了 5 行,导航上算 1 处,按一下滚动过去一次看全,不用按五次。 ✅ 三种报告,都能发人 01 HTML 对比报告:自带样式,CSS 全内联,双击就能看,不依赖任何外部文件,发给别人不会掉样式 02 Excel 差异清单:新增行 / 删除行 / 修改行 / 汇总统计四个 sheet,带底色 03 统一 txt:+ / - 前缀,跟 diff -u 一个口味 ✅ 还能两个文件夹批量比 选两个文件夹(A 旧、B 新),按相对路径两两配对:同名文件一一对比,只在 A 有的、只在 B 有的都会单独列出来,出一份总报告。 真实素材上的实测 我们造了三版合同(v1 → v2 → v3,其中 v3 还故意存成 GBK 编码)、一份制度 docx 和它的修订版、两份员工名单 xlsx、两份产品说明 PDF,还有一份纯图片的扫描件 PDF。 拿工具跑: 01 合同 v1 ↔ v2:新增 1 行 / 删除 0 行 / 修改 4 行 / 相似度 89.6%。改的是金额(壹万贰仟 → 壹万伍仟)、交货期(十五 → 十个工作日)、违约金(千分之三 → 千分之五),第六条整条换成了质保期条款,并新增第七条。 02 合同 v1 ↔ v3(GBK):新增 2 行 / 修改 4 行 / 相似度 86.4%。注意 v3 是 GBK 编码的,工具自动认出来了,没有乱码。 03 考勤制度 ↔ 修订版:修改 3 行 / 新增 1 行 / 相似度 83.3%。上班时间从九点改成八点半、财务部负责人从李四改成王五、电话也换了,还新增了加班申请的条款。 04 扫描件 PDF ↔ 产品说明 PDF:直接报错「这份 PDF 没有文字层,建议先 OCR」——这正是我们要的行为。 05 两个文件夹批量比(8 个条目):有差异 2、完全一致 4、只在 A 有 1、只在 B 有 1,全部标出来了。 局限也一并说了 01 老格式不支持:.doc / .xls / .ppt 是二进制,工具会明确报「二进制文件,跳过」,请先另存为新格式 02 PDF 抽文字会丢版式:表格会被拉平,别拿 PDF 的结果去比排版 03 相似度是个参考数字:不代替人的判断 04 界面没做高分屏缩放适配:200% 缩放下字会偏小 04 04 265 条断言,全绿才发 自检全程在临时目录里造数据,跑完删干净,不碰你的任何文件。 265 条断言,0 失败才算过。而且它验的是真东西: 01 造真的 02 造一份纯图片 PDF,断言工具抛出错误、错误里必须出现「没有文字层」和「OCR」 03 每个开关正反两向都验:ABC vs abc 忽略大小写时 0 处差异、不忽略时 1 处差异 04 差异定位:["第一行","第二行","第三行"] vs ["第一行","第二行改了","第三行","第四行"] → 断言新增 1、删除 0、修改 1 05 相似度:完全相同 = 1.0;顺序全反 实测 1/3;改一个字不等于 0% 06 行内高亮:今天天气很好 vs 今天天气不太好 → 断言高亮位置抠出来的就是那几个字 07 文件夹批量:造同名 + 只在 A 有 + 只在 B 有,断言数量对得上 08 边界:空文件、一边空、两边空、12 万字一行、300 行全改、8000 行重复、二进制、只读文件 09 界面:真的把 Tk 窗口建起来、断言标题和控件都在,再销毁——不是只 import 一下就算数 三个技术决定,都是被实测逼出来的 第一,相似度不能只按行算。 第二,必须先削掉共同的头和尾。 改过一版的合同 95% 的行是一模一样的。直接把整份丢给 SequenceMatcher,遇到「大量重复短行」(几百行都是「同上」的表)会退化成 O(n²);而如果因此打开 autojunk=True,又会把重复行当垃圾忽略掉——一份 8000 行同内容的稿子会被算成「改了 8000 行」(实测)。所以先削共同头尾(diff 的标准做法),剩下的中间通常很小。8000 行里改 1 行,实测 0.114 秒,精确报出 1 处修改。 第三,行内高亮用 Levenshtein,不用 SequenceMatcher 的 opcode。 对「今天天气很好」→「今天天气不太好」,SequenceMatcher 会切成「删『很』+ 插『不太好』」,编辑距离 3;而「只插一个『不』」编辑距离只有 2——后者更短,也更符合直觉。所以行内对齐用 Levenshtein(替换代价 = 1),它天然偏向保留相同的字。代价是 O(n·m),所以只在两行都不长时才用;超长行直接跳过行内高亮,并在备注里明确写出来,不许假装比过。 说句老实话:上面这个例子,工具实际切出来是「删『很』+ 插『不太』」——因为两种切法编辑距离都是 2,打平,程序选了改动字数一样的那一种。这不是 bug,是「最短编辑」原则的必然结果,自检里把这个行为钉死了。 打包的时候被坑过 这台机器上装了奇安信。实测「体积小的未签名单文件 EXE」会被它短时间隔离,表现是抛假的 PermissionError,重试、等待都救不回来(实测等 65 秒仍然全拒);更狠的是它会直接把 EXE 删掉。 到底多小算小?我们量过两轮,结论没能收敛:第一轮 8.4 MB / 13.3 MB 失败、21.1 MB / 31.4 MB 成功;后来换一份探针再量,8.4 MB 稳定失败,10.5 MB 和 14.7 MB 却都成功了。所以「20 MB 是临界线」这句话我们不写死,只写「包做大就没事」。 所以:产物 42.9 MB(≥30 MB 是硬规矩),而且打包和自检挤在同一个进程里完成,中间不给它留删除的窗口。 05 05 我们不做知识付费,不贩卖焦虑 上面说的那些场面——合同的「好像改了」、制度文件的 8 个版本、论文查重前的忐忑、两份名单的对账——没有一个是「你不够努力」造成的。它们只是缺乏一个趁手的工具。 这个工具离线运行,不联网,不上传任何内容。合同也好、工资表也好、名单也好,全程只在你自己电脑的内存里比。这一点对我们来说不是「特色功能」,是底线。 工具在群里,关注公众号回复「进群」直接领。42.9 MB,双击就跑,不用装 Python,不用注册,没有试用期,不弹广告。 源码就一个文件,全中文注释,连踩过的坑都写在注释里。想改成你要的样子,自己动手就行。 06 工具下载 文本对比工具,双击就跑。两份文稿往里一放,逐行 / 逐字 / 逐段比差异,增绿删红改黄,导出自带样式的 HTML 报告发人就能看。 docx、xlsx、pdf 都能比,编码自动识别,扫描件没文字层会明确告诉你。两个文件夹还能批量比,谁多了谁少了一次说清。 完全离线,不上传。 链接:https://pan.baidu.com/s/1UAcmVqOx76F75hlJGrShhg?pwd=u4cy 提取码:u4cy 阅读原文:点击这里 该文章在 2026/10/28 8:55:31 编辑过 |
关键字查询
相关文章
正在查询... 
|


 400 186 1886